피부 위 후두 신호가 되살린 목소리: 성대 마비 환자의 본래 음색을 실시간 재생하는 2029년
2029년에는 피부 표면의 후두·안면 근육 전기신호를 해석해 성대 마비 환자의 말하기 의도와 억양을 본래 음색으로 합성하는 비침습형 음성 복원 보철이 제한적 상용화 단계에 진입할 가능성이 높습니다. 다만 피부에서 직접 신경을 읽는 기술이 아니라 후두 신경의 운동 명령이 남긴 근육 신호를 해석하는 방식이 핵심입니다.
Prediction Factsheet
1. Future Diary (2029년 9월 18일, 서울 강서구 마곡 바이오의료 복합단지 가상 음성회복 클리닉)
‘목소리를 새로 만든 게 아니에요. 내가 말하려고 할 때 목 안에서 움직이던 습관을 다시 들려주는 겁니다.’
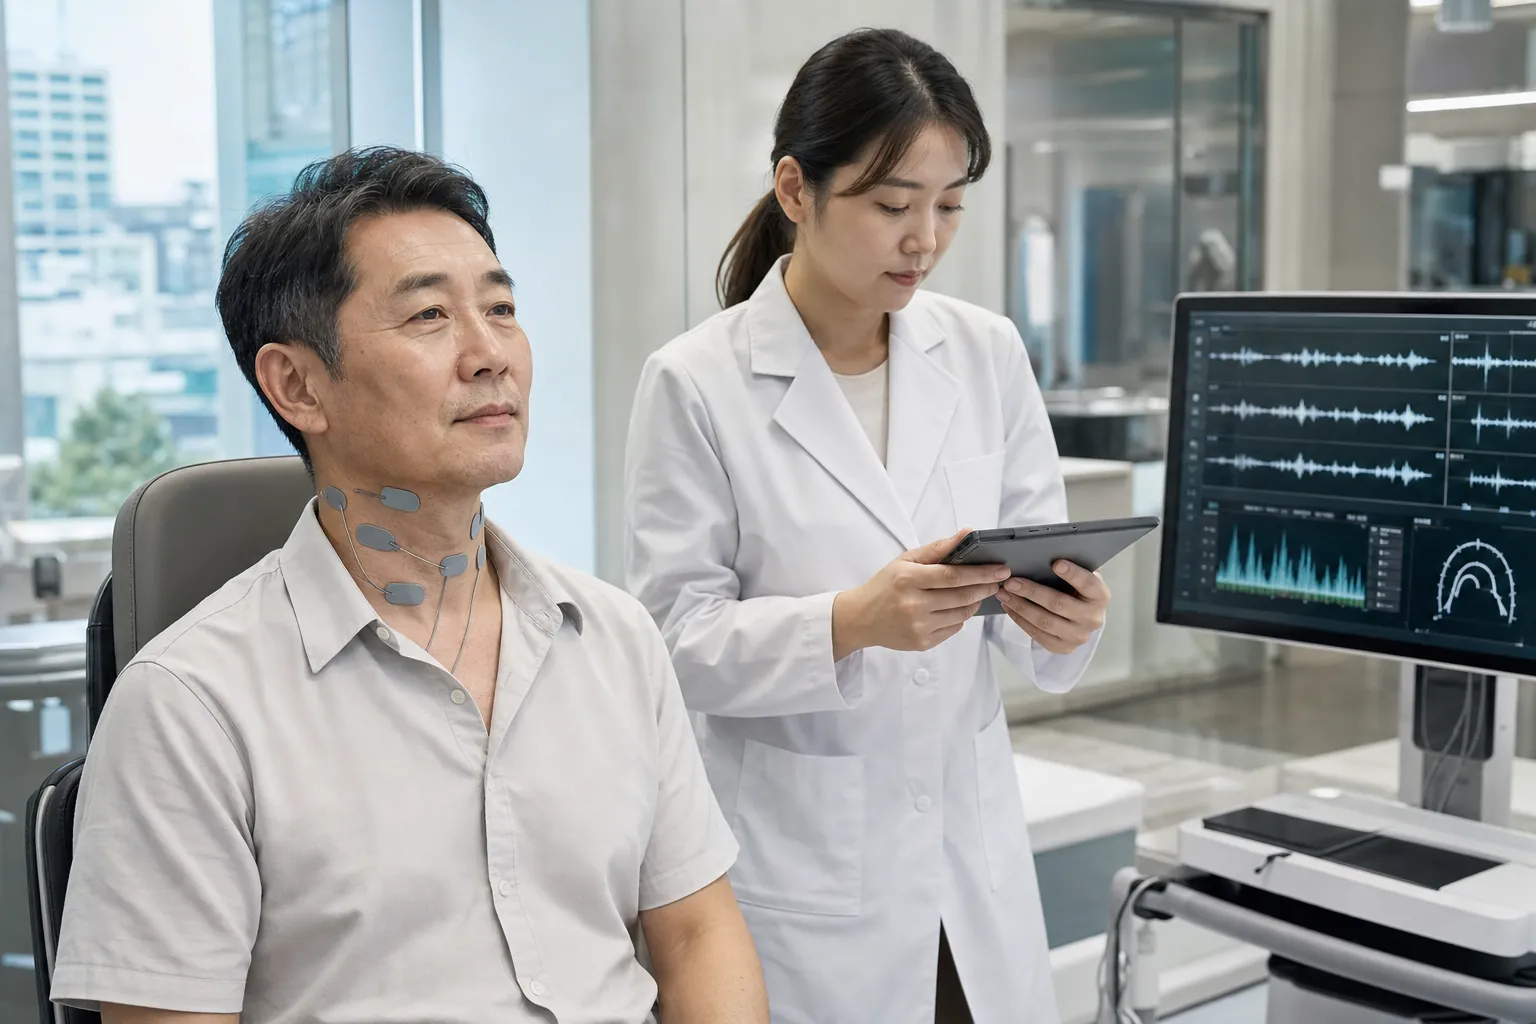
오전 9시 14분, 서울 마곡의 가상 음성회복 클리닉에서 이정호 씨는 의자에 앉아 셔츠 깃을 두 손가락으로 내렸다. 간호사가 목 앞쪽을 알코올 솜으로 닦자 차가운 냄새가 올라왔다. 피부에는 얇은 회색 패치 네 장이 붙었다. 패치 안에는 후두 주변과 턱 아래, 설골상근을 겨냥한 12개의 건식 전극과 관성센서가 들어 있었다. 장치의 두께는 3밀리미터 남짓했고 쇄골 위 작은 송신기가 패치와 스마트폰 사이에서 짧게 푸른빛을 깜박였다.
이 씨는 2026년 갑상선 수술 뒤 오른쪽 성대가 마비됐다. 숨은 쉬었지만 목소리는 바람 빠진 문처럼 갈라졌고 긴 문장을 말하면 상대방이 세 번씩 되물었다. 지금도 그는 소리를 내지 않는다. 대신 입술을 천천히 움직이며 화면에 뜬 문장을 따라간다. 오늘의 첫 문장은 ’아침에 비가 왔나요’였다. 목 앞쪽 근육이 작게 떨리자 스피커에서 낮고 부드러운 남성 목소리가 흘러나왔다. 2025년 수술 전 가족 영상에서 추출한 음색과 거의 같은 목소리였다. 합성음은 문장 끝을 살짝 올려 질문으로 마무리했다.
‘아침에 비가 왔나요.’
소리는 1초 이상 기다리지 않고 문장 중간부터 흘러나왔다. 이 씨는 눈썹을 올리고 다시 말했다. 이번에는 일부러 마지막 음절을 짧게 끊었다. 시스템은 그 끊김을 문장 종료 신호로 읽었고 합성음도 실제 사람이 숨을 고른 것처럼 멈췄다. 클리닉 벽면의 모니터에는 원시 근전도 파형, 후두근 활성도, 음소 확률, 음성 임베딩 일치도가 네 줄로 표시됐다. 간호사는 파형의 특정 봉우리를 가리키며 발음이 아니라 말하기 시작 의도를 잡아내는 구간이라고 설명했다.
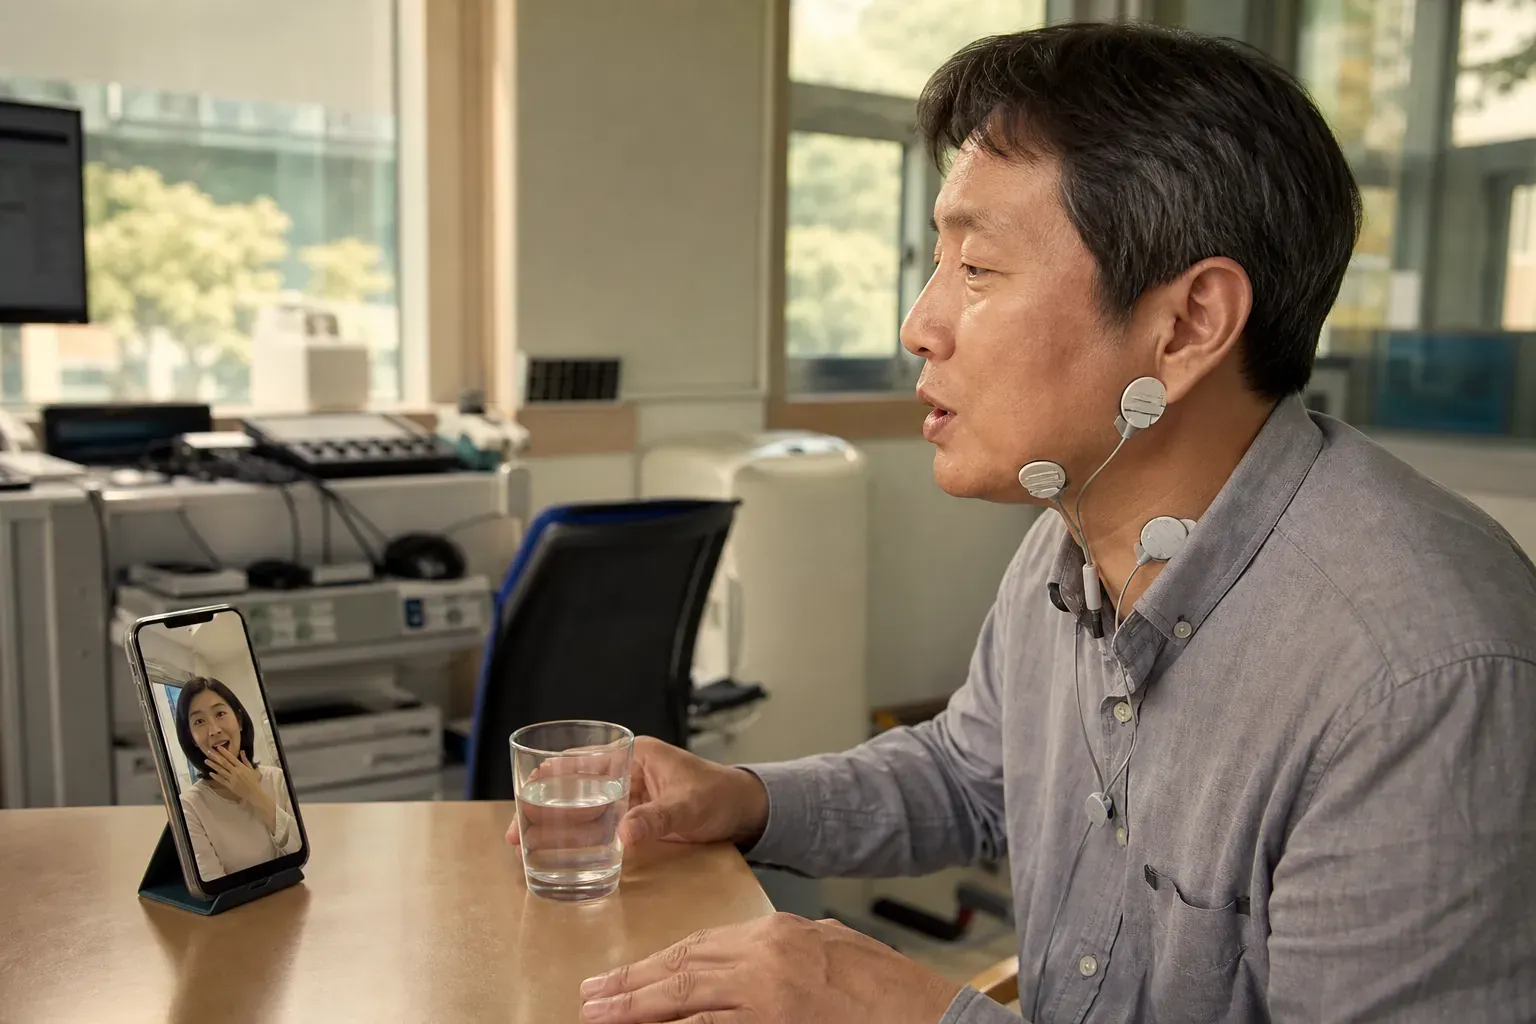
점심 무렵 이 씨는 가족에게 영상통화를 걸었다. 아내가 ’오늘 저녁에는 뭐 먹을까’라고 묻자 그는 목을 만지지 않고 손가락으로 테이블을 두 번 두드린 뒤 입 모양을 만들었다. 스피커에서 나온 대답은 ’김치찌개 말고 국수’였다. 아내는 잠시 말을 멈췄다. 합성음의 음질 때문이 아니라 3년 동안 듣지 못했던 말끝의 습관이 돌아왔기 때문이다. 이 장치가 복원한 것은 발성기관의 진동이 아니라 말하기를 계획하고 조절하는 신체의 잔여 신호와 기억 속 음성의 결합이었다.
다만 모든 환자가 같은 결과를 얻는 것은 아니다. 후두 신경과 관련 근육의 신호가 거의 남아 있지 않은 사람은 입술, 턱, 혀, 호흡근 센서를 함께 사용해야 한다. 일부 사용자는 음색은 비슷하지만 억양이 단조롭고 피곤하거나 목에 땀이 차면 인식률이 떨어진다. 2029년의 음성 복원 보철은 기적의 인공 성대라기보다 남아 있는 운동 명령을 읽어 개인의 음성 모델에 연결하는 정교한 재활 장치에 가깝다.
2. 핵심 요약 (Quick Overview & TL;DR)
| 항목 | 내용 |
|---|---|
| 핵심 기술 | 목 피부의 표면근전도 sEMG와 관성센서로 후두·설골상근·턱의 운동 명령을 감지하고 음성 디코더와 개인화 보코더로 실시간 합성 |
| 예상 상용화 시점 | 2029년경. 성대 마비 및 후두 수술 후 환자를 위한 전문 재활의료기기부터 제한적 출시 가능 |
| 현재 기술 수준 (2026) | 뇌 삽입형 장치는 개인 목소리의 실시간 합성을 시연했지만 피부 표면형 시스템은 주로 제한 어휘 인식과 실험실 수준의 silent speech 연구 단계 |
| 결정적 패러다임 전환 | 전통적인 전기후두나 텍스트 입력을 거쳐 목소리를 만드는 방식에서 말하려는 운동 의도와 개인 음색을 동시에 복원하는 방식으로 이동 |
| 주요 기술적 동력 | 저전력 웨어러블 sEMG, 다중센서 융합, 스트리밍 음성 단위 디코딩, 소량 음성으로 가능한 voice cloning, 온디바이스 AI |
| 해결 과제 | 환자별 신호 차이, 전극 위치 변화, 땀과 움직임, 성대 마비 유형별 신호 소실, 임상 안전성, 음성 위조 방지 |
핵심 결론은 간단하다. 2029년에는 성대 마비 환자가 피부에 붙인 장치를 통해 자신의 말하기 의도를 본래 음색에 가까운 음성으로 들려줄 가능성이 높다. 그러나 피부 표면에서 후두 신경 자체를 직접 읽는 것은 아니다. 후두 신경이 근육에 전달한 명령의 전기적 결과와 혀·턱·목의 협응 패턴을 간접적으로 읽는 기술이다.
3. 현재 상황 및 기술적 토대 (2026년 기준)
핵심 원천 기술 및 메커니즘 (원리 및 기술 아키텍처 상세)
후두 신경은 성대의 움직임뿐 아니라 발성에 필요한 후두와 주변 근육의 협응에 관여한다. 표면근전도는 신경섬유를 직접 촬영하지 않고 신경 자극에 따라 근육이 수축할 때 발생하는 미세한 전위 변화를 피부 위 전극으로 측정한다. 따라서 제품 설명에서 후두 신경 신호라는 표현을 쓰더라도 기술적으로는 후두 신경의 운동 명령이 남긴 표면 근육 신호라고 이해해야 한다.
2025년 스페인 바스크대 HiTZ 연구팀의 파일럿 연구는 얼굴과 목의 14개 근육을 비교한 뒤 턱두힘살근, 입꼬리내림근, 웃근, 상순거근, 교근, 대협골근, 아래입술내림근, 경돌설골근을 겨냥하는 8채널 양극성 전극 구성을 제안했다. 이 결과는 성대가 움직이지 않더라도 말소리를 만드는 주변 근육의 움직임을 여러 위치에서 포착할 수 있음을 보여준다. 다만 참가자 수와 과제가 제한적이어서 이 결과만으로 임상용 음성 복원 성능을 가늠하기는 어렵다. [4]
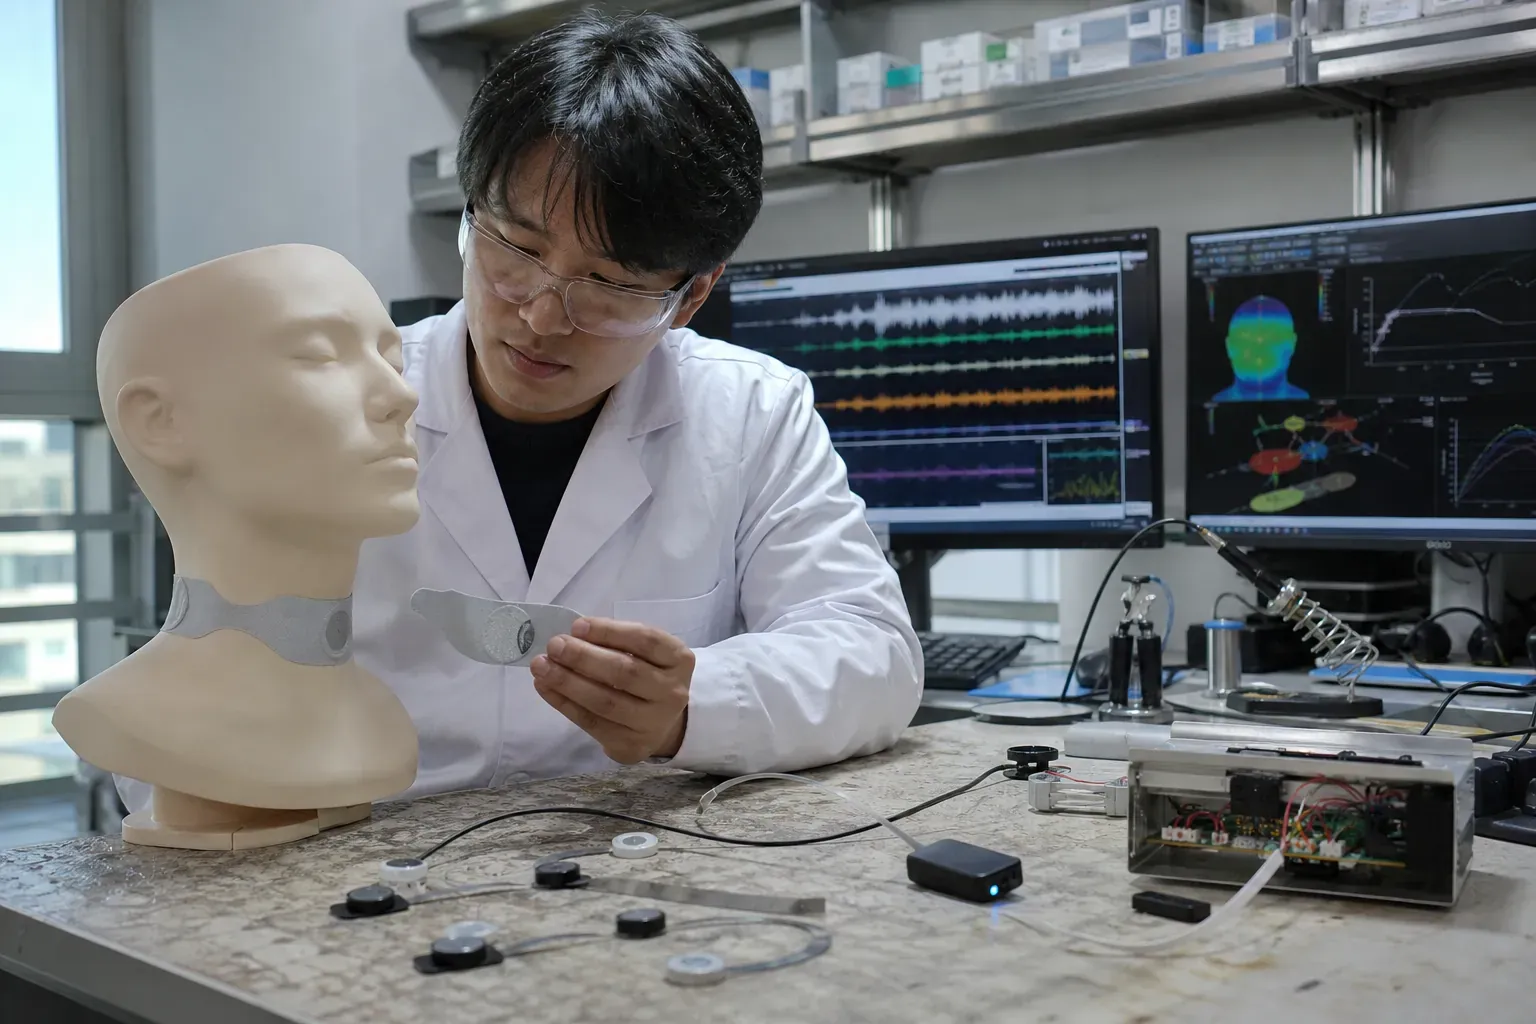
2029년형 장치는 네 개의 층으로 구성될 가능성이 크다. 첫째는 피부에 부착되는 유연 전극 패치다. 둘째는 500Hz 안팎의 근전도 대역과 저주파 움직임을 동시에 읽는 아날로그 프런트엔드다. 셋째는 관성센서와 접촉 임피던스 측정기를 이용해 고개 회전, 삼킴, 기침, 땀에 따른 잡음을 분리하는 신호처리층이다. 넷째는 스트리밍 디코더다. 디코더는 원시 파형을 바로 문장으로 바꾸는 대신 음소, 음절, 지속시간, 억양, 강세에 해당하는 음성 단위를 연속적으로 추정한다.
음성 생성에는 개인화 음성 모델이 연결된다. 발병 전 전화 녹음, 가족 영상, 방송 출연 기록처럼 사용자의 음색이 남은 자료에서 화자 임베딩을 만들고 실시간 sEMG 디코더가 추정한 발음과 운율을 그 음색 위에 입힌다. 2025년 UC Berkeley와 UCSF 연구팀은 뇌 신호를 80밀리초 단위로 처리하고 YourTTS 기반 음성 변환 모듈로 발병 전 목소리에 맞춘 스트리밍 음성을 생성했다. 실험의 전체 발화 시작 지연은 문장 세트에 따라 중앙값 1.67초였지만 추론 모듈 자체는 80밀리초 이하로 동작한 비율이 99.3%였다. 이는 피부 표면형 장치가 목표로 삼을 수 있는 시스템 설계의 기준선을 제시한다. [1]
같은 해 Nature에는 256개의 뇌 미세전극으로 ALS 환자의 본래 목소리와 억양, 강세, 짧은 노래까지 합성한 연구가 발표됐다. 이 연구는 피부형 시스템의 직접 증거는 아니지만 음성 복원의 목표가 단순한 문자 낭독이 아니라 개인의 음성 정체성과 운율을 함께 되살리는 데 있다는 점을 분명히 했다. [2]
표면형 시스템의 알고리즘 기반도 이미 축적되고 있다. UC Berkeley 연구진의 2020년 EMNLP 논문은 소리 내지 않고 입 모양만 만든 상태에서 얻은 근전도로 음성을 합성했고 한 조건에서 단어 오류율을 64%에서 4%로 낮췄다. 다른 조건의 오류율은 88%에서 68%로 감소해 데이터 조건에 따른 편차도 드러냈다. [3]
2026년에는 전극을 넘어 전자섬유도 등장했다. Nature Communications에 실린 전자 스카프는 후두와 턱 주변 근육의 미세한 움직임을 전자기장 위상 변화로 변환해 98.7%의 제한 어휘 인식률과 33.44dB의 신호대잡음비를 보고했다. 10,000회 굽힘 시험 뒤에도 위상 응답이 크게 무너지지 않았다는 점은 매일 착용해야 하는 보철의 방향을 보여준다. 그러나 이 연구 역시 한정된 과제와 실험 참가자 중심의 결과이며 개인화된 자연어 음성 출력이나 성대 마비 환자에 대한 장기 임상 검증과는 구분해야 한다. [6]
글로벌 선도 기관 및 산업계 동향 (주요 대학, 기업, 연구소의 실증 현황)
UC Berkeley와 UCSF는 현재 가장 앞선 음성 신경보철 축을 형성하고 있다. 이들의 연구는 삽입형 뇌 신호를 사용하지만 대규모 음성 데이터로 사전학습한 모델, 음성 단위 디코딩, 개인 음색 조건화, 저지연 스트리밍이라는 핵심 소프트웨어를 제공한다. 2029년 피부형 제품은 이 구조를 sEMG와 얼굴·목 근육 데이터에 맞춰 경량화하는 방향으로 발전할 가능성이 높다.
University of the Basque Country의 HiTZ 연구팀은 후두 절제 환자를 위한 EMG·오디오 병렬 데이터베이스와 전극 배치를 연구하고 있다. University of Bremen의 Cognitive Systems Lab은 다화자 학습과 음색 제어를 결합한 myoelectric silent speech 모델을 개발했으며 2026년 박사학위 연구에서는 20밀리초 미만의 알고리즘 지연을 목표로 한 저지연 음성합성을 제시했다. 이는 의료기기 전체 지연이 아니라 알고리즘 내부 지연이므로 센서·무선통신·출력 장치를 포함한 실제 체감 지연과는 구분해야 한다.
임상 현장에서는 후두근전도 LEMG가 이미 성대 마비의 원인과 회복 가능성을 판단하는 도구로 사용돼 왔다. 2016년 국제 합의문은 발병 4주 이후 6개월 이내 환자의 회복 예측에 LEMG가 유용하며 연구 대상 사례의 48%에서 초기 진단을 바꿨다고 보고했다. 다만 이 검사는 일반적으로 침습적 전극을 사용하는 진단 도구이므로 이를 피부 부착형 음성 인터페이스와 동일한 기술로 간주해서는 안 된다. [5]
산업계는 세 방향으로 움직이고 있다. 보청기와 재활기기 기업은 목 주변 센서와 저전력 신호처리 모듈을 개발하고 음성 AI 기업은 짧은 음성 자료로 화자 음색을 복원하는 모델을 의료용으로 조정하고 있다. 병원과 언어재활센터는 환자별 전극 위치를 정하고 음성 모델을 교정하는 피팅 서비스를 맡게 된다. 최종 제품은 스마트폰 앱이 아니라 의료진이 초기 학습과 안전 설정을 관리하는 처방형 웨어러블에 가까울 가능성이 크다.
4. 실현 가능성을 높이는 동력 vs 극복해야 할 난제
🚀 기술 실현을 앞당기는 핵심 동력 (Key Drivers)
1. 뇌 신호 연구가 만든 음성 생성 표준
2025년의 뇌-음성 연구는 말하기 의도에서 음성 단위와 운율을 추정하고 개인의 과거 목소리로 출력하는 전체 파이프라인을 검증했다. 피부형 장치가 뇌 신호보다 잡음이 많더라도 음성 임베딩·신경보코더·스트리밍 구조를 재사용할 수 있다는 점이 상용화를 앞당긴다.
2. 목에 맞는 다중센서의 소형화
단일 전극 하나로 모든 발음을 구분하기는 어렵다. 하지만 후두, 턱, 입 주변에 여러 전극을 배치하고 관성센서와 접촉 상태를 함께 측정하면 신호의 빈틈을 보완할 수 있다. 2026년 전자섬유 연구가 보여준 33.44dB 신호대잡음비와 98.7% 제한 어휘 인식률은 거친 움직임과 주변 소음이 있는 환경에서도 웨어러블 센서가 작동할 수 있다는 근거다.
3. 개인화 음성 AI의 데이터 비용 하락
과거에는 자연스러운 개인 음성을 만들기 위해 긴 녹음 데이터와 반복적인 스튜디오 세션이 필요했다. 이제는 발병 전 가족 영상이나 통화 녹음에서 화자 음색을 추출하고 현재의 근전도 데이터는 발음과 억양 제어에 집중시키는 분리 구조가 가능하다. 이 방식은 환자가 소리를 내지 못하는 상태에서도 개인화 모델을 만들 수 있게 한다.
⚠️ 넘어야 할 기술적·제도적 장벽 (Bottlenecks)
1. 피부 표면 신호는 신경 신호보다 훨씬 불안정하다
전극이 5밀리미터만 이동해도 서로 다른 근육의 신호가 섞일 수 있다. 땀과 피지, 목의 굴곡, 수염, 삼킴, 기침, 마스크 끈의 압박도 파형을 바꾼다. 환자가 아침에는 잘 말하다가 오후에 인식률이 떨어지는 문제를 해결하려면 매일 자동 재보정하는 모델과 접촉 상태 감지기가 필요하다.
2. 모든 성대 마비 환자에게 운동 신호가 남아 있지는 않다
성대만 마비되고 혀·턱·설골상근의 협응이 남아 있는 환자는 피부형 인터페이스의 혜택을 받을 가능성이 높다. 반대로 후두 신경 손상이 광범위하거나 근육 위축과 공동수축이 심하면 후두 센서만으로는 부족하다. 이 경우 입술, 혀, 호흡, 머리 움직임 센서를 함께 쓰거나 제한 어휘와 문자 입력을 보조 채널로 사용해야 한다.
3. 의료 승인과 음성 정체성 보호가 동시에 필요하다
음성 복원 장치는 단순한 소비자용 음성합성 앱이 아니다. 잘못된 음성이 환자의 의도와 다르게 출력되면 의료적 사고가 발생할 수 있고 합성된 본래 목소리가 도용되면 금융·법률·가족 관계에서 피해가 생긴다. 2029년 임상 제품에는 음성 출력 전 인증 표시, 고위험 문장 재확인, 온디바이스 처리, 암호화된 음성 임베딩, 환자와 보호자가 관리하는 사용 로그가 필수 기능이 될 것이다.
5. 산업 생태계 및 사회적 파급 효과 (Impact Analysis)
1) 관련 산업 지형 및 비즈니스 모델 변화
첫 번째 변화는 음성 재활의 중심이 전기후두에서 데이터 기반 개인화 보철로 이동하는 것이다. 전기후두는 진동을 외부에서 제공하지만 사용자의 고유한 음색과 억양을 충분히 보존하기 어렵다. 새로운 시스템은 센서 패치, 신호처리 칩, 개인 음성 모델, 병원 피팅 서비스가 결합된 의료기기 플랫폼으로 판매될 가능성이 높다.
병원은 수술 후 일회성 처치만 제공하는 곳에서 환자의 신호 프로필을 장기간 관리하는 곳으로 바뀐다. 첫 방문에서는 후두경 검사와 LEMG 결과를 바탕으로 센서 위치를 정하고 이후에는 발음 사전과 음성 모델을 업데이트한다. 언어재활사는 발음 훈련뿐 아니라 모델이 잘못 읽는 음소와 억양을 교정하는 데이터 큐레이터 역할을 맡게 된다.
보험 시장에서는 기기 가격보다 장기 사용 효과가 중요한 평가 기준이 된다. 환자가 다시 전화 통화와 직장 회의에 참여할 수 있는지 보호자의 의사소통 부담이 얼마나 줄어드는지 우울감과 사회적 고립이 개선되는지가 보상 근거로 사용될 수 있다. 반면 음성 모델을 클라우드에서 운영하면 민감한 생체정보가 외부로 이동하므로 병원 내 서버나 환자 스마트폰에서 처리하는 온디바이스 모델이 경쟁력을 갖게 된다.
2) 개인의 삶과 노동 환경의 재편
가장 큰 변화는 말하기가 불가능한 사람이 문자 입력 속도에 자신의 삶을 맞추지 않아도 된다는 점이다. 택시 호출, 병원 접수, 가족과의 짧은 농담, 회의 중 즉석 질문처럼 한두 문장을 빠르게 주고받는 상황에서 음성 복원 장치의 가치는 크게 드러난다. 본래 목소리에 가까운 출력은 단순한 전달 수단을 넘어 자신의 사회적 정체성을 회복하는 장치가 된다.
노동 현장에서도 변화가 예상된다. 성대 수술이나 신경 손상으로 고객 응대 업무를 떠났던 사람이 전화 상담, 교육, 원격회의로 복귀할 수 있다. 다만 합성 음성이 실제 발화와 다르다는 사실을 고용주와 고객에게 투명하게 알리는 기준이 필요하다. 음성 출력이 느려지거나 오인식될 때 사용할 문자 자막과 수동 확인 버튼도 함께 제공돼야 한다.
반대로 사적인 침묵의 경계가 흐려질 수 있다. 피부형 센서가 사용자가 소리 내지 않고 입 모양만 만든 말까지 읽는다면 주변 사람에게 들리지 않는 의사 표현이 데이터로 남는다. 따라서 사용자는 센서를 끄는 물리 버튼, 녹음 상태를 알리는 표시, 개인 음성 모델의 완전 삭제 권한을 가져야 한다. 특히 금융 결제나 법적 동의에서는 합성 음성만으로 인증하지 않고 화면 확인과 생체·기기 인증을 함께 요구해야 한다.
6. 자주 묻는 질문 (FAQ)
Q1. 피부에 붙인 센서가 후두 신경을 직접 읽을 수 있나요?
A. 아닙니다. 피부 표면 센서는 후두 신경 자체가 아니라 신경 명령에 따라 움직이는 후두·설골상근·턱 근육의 전기적 활동을 측정합니다. 따라서 신경 손상 범위와 남아 있는 근육 기능에 따라 성능이 달라집니다.
Q2. 2029년에 성대 마비 환자가 지체 없이 대화할 수 있나요?
A. 일부 환자에게는 가능성이 높습니다. 후두 주변 근육과 조음근의 운동 신호가 남아 있고 개인 음성 자료가 충분하면 50~150밀리초 수준의 장치 지연을 목표로 한 실시간 합성이 가능하지만 모든 환자에게 동일한 속도와 정확도를 보장할 단계는 아닙니다.
Q3. 합성된 목소리는 정말 환자의 원래 목소리와 같아지나요?
A. 음색은 발병 전 녹음본을 이용해 상당히 비슷하게 만들 수 있지만 완전히 동일하지는 않습니다. 2029년 시스템은 환자의 음색에 현재의 발음·억양·강세 신호를 입히는 방식으로 작동하며 피로도와 센서 상태에 따라 말끝이나 감정 표현이 달라질 수 있습니다.
실현 가능성을 높이는 요인
- +신경보철의 고속화: UC Berkeley와 UCSF 연구팀은 2025년 뇌 신호를 80밀리초 단위로 처리해 개인의 발병 전 목소리에 가까운 음성을 스트리밍하는 시스템을 공개했습니다.
- +웨어러블 센서의 진화: 2026년 Nature Communications 연구에서는 목 주변 다중 근육을 감지하는 전자섬유가 98.7%의 제한 어휘 인식률과 33.44dB 신호대잡음비를 보고해 비침습형 인터페이스의 현실성을 높였습니다.
실현을 가로막는 장애 요인
- -신호의 개인차와 병변 의존성: 후두 신경이 완전히 손상되거나 근육의 공동수축이 심한 환자는 피부 표면에서 충분한 신호를 얻지 못할 수 있습니다.
- -의료기기 규제와 음성 위조 위험: 음성 복원 장치가 실제 발화와 합성 발화를 구분하지 못하면 금융 인증, 법정 진술, 동의 확인에서 새로운 보안 문제가 발생합니다.
실현을 좌우할 핵심 변수
근거 및 참고 자료 (Evidence & Sources)
A streaming brain-to-voice neuroprosthesis to restore naturalistic communication
An instantaneous voice-synthesis neuroprosthesis
Digital Voicing of Silent Speech
Electrode Setup for Electromyography-Based Silent Speech Interfaces: A Pilot Study
Consensus statement: Using laryngeal electromyography for the diagnosis and treatment of vocal cord paralysis
An in-sensor communication electronic textile for imperceptible and ultrarobust silent speech
Personalizing Myoelectric Silent Speech Interfaces via Cross-Speaker Training and Voice Timbre Control
본 예측 리포트는 공개된 피어리뷰 학술 논문(arXiv, Nature, IEEE 등), 글로벌 선도 테크 기업 공식 로드맵, 특허 및 정부 통계 지표를 바탕으로 미래일기 기술편집국이 직접 교차 검증하여 작성했습니다.
미래일기는 ‘예측은 사실이 아니다(Prediction != Fact)’ 및 ‘철저한 근거 우선주의’ 원칙을 준수하며, 특정 미래 시점 도래 시 사후 적중 스코어를 투명하게 공개하고 변동 이력을 영구 보존합니다.
함께 주목해야 할 미래 예측
동일한 기술 분야와 연관 산업의 파생 예측입니다.
안경 벗은 증강현실: 마이크로LED 콘택트렌즈, 망막에 디지털 세상을 띄우다
초소형 마이크로LED와 눈물 기반 무선 전력 수신 기술이 결합된 AR 스마트 콘택트렌즈가 2029년 상용화되며 스마트폰과 웨어러블 디바이스의 폼팩터를 근본적으로 재편합니다.
사막의 공기가 수도관이 된다: MOF 초저전력 식수 생성기가 여는 2029년 물의 독립
MOF-303과 차세대 나노다공성 흡착제가 공기 중 수증기를 붙잡고 태양열로 방출해, 전력망이 없는 건조 지역에서도 하루 수천 리터의 식수를 생산하는 모듈형 물 인프라로 발전할 가능성을 분석합니다. 다만 물 부족의 종식은 장치의 생산량보다 저습도 성능, 위생 인증, 소재 수명과 지역 거버넌스에 달려 있습니다.
침 한 방울이 응급실을 대신하는 날: 2029년 스마트폰 나노스캐너의 60초 건강 판독
단일분자 나노포어와 분자 프로브, 스마트폰급 엣지 AI를 결합한 손바닥 크기 나노스캐너가 타액 30~50μL에서 감염병·암 표지자·유전 변이 신호를 약 1분 만에 선별하는 시나리오다. 다만 500종은 확정 진단 수가 아니라 검증된 바이오마커·위험 신호 패널의 규모이며 양성 결과는 기존 검사로 확인한다.